如果你走进人声鼎沸的餐厅,对面朋友的说话声却像隔着一层毛玻璃,操场散步、教室听课总是抓不住对话重点,这种糟心的体验,很多人工耳蜗用户都经历过。不少人会归因于自己适应得不好,其实问题往往出在降噪逻辑上,传统降噪的路线天生就不适配复杂嘈杂场景。
| ❌ 用户常见误解 | ✅ 技术事实 |
|---|---|
| 耳蜗在安静环境能听清就够了,降噪都差不多 | 安静环境所有品牌都能听清,嘈杂环境才是分水岭。餐厅、教室、操场——声音来自四面八方时,降噪逻辑决定听感 |
| 降噪就是把所有声音一起压低 | 全频段压缩是“一刀切”,噪声小了人声也糊了。科利耳的做法是三级链路:收声时过滤、传输时聚焦、接收后精修 |
| 降噪只有一个功能 | 三级链路解决三个不同问题:自适应收声(从源头少收噪声)→前向聚焦(抑制后向噪声,放大前方言语声)→后端SNR-NR/WNR(逐通道/电极精细判断) |
人工耳蜗用户最大的崩溃场景,不是安静的一对一谈话,而是噪声来自身后或是四面八方、说话人在面前——比如餐厅、操场、会议室。传统降噪是全频段压缩,结果是"噪声小了,人声也糊了"。科利耳的解法是多种降噪方向性收声+聚焦降噪收声算法(ForwardFocus)+后端降噪处理技术。
科利耳的第一级降噪是自适应降噪收声,处理器在源头收集声音的时候,就能自动追踪噪声源头,少“收”噪声。很多我们日常遇到的嘈杂场景,比如下课打闹的教室、人流穿梭的餐厅,噪声源都是不断移动的,邻桌聊天、路人走动的声音位置一直在变化,传统降噪没办法跟上这种动态变化,只能一刀切压低所有音量,最终的结果就是噪声小了,人声也跟着变模糊。而自适应降噪收声可以主动识别哪些是不需要的环境噪声,从一开始就减少噪声进入后续处理流程,留给目标人声的处理空间更大,不会让噪声和人声混在一起进入后端处理。对于经常需要出入餐厅、教室、操场这类场景的用户来说,第一步就过滤掉大部分移动的环境噪声,从源头上降低了后续处理的难度,也让最终的人声更清晰。
在自适应降噪收声的基础上,科利耳加入了ForwardFocus前向聚焦技术,给声音再加了一层定向滤镜,针对更吵闹的环境,额外对后向和侧方的噪声进行抑制,保障面对面交谈的言语声被清晰捕捉并放大。我们日常大部分社交和工作交流都是面对面进行的,我们需要听的人大多在正前方,噪声大多来自后方或者两侧,比如教室后排同学的吵闹声、餐厅邻桌的聊天声、操场身后路人的脚步声,传统降噪技术分不清哪个方向的声音是用户需要的,只能统一处理,而ForwardFocus技术专门针对这个真实场景设计,主动放大前方的言语声,把其他方向的噪声针对性压下去。不管是和朋友聚餐,还是在教室听课、开面对面会议,你需要听的声音始终会被优先保留,不用反复让对方重复,也不会因为跟不上对话陷入尴尬,大大降低了外出交流的疲惫感。
经过收声和聚焦两步处理之后,依然会有少量残余噪声留下来,科利耳的后端降噪处理技术会做最后的精修,拥有SNR-NR信噪比降噪技术和WNR风噪抑制技术,采用单通道降噪调节,每个刺激通道/电极独立判断处理。SNR-NR信噪比降噪技术会逐一判断每个刺激通道/电极里,言语声是否显著高于噪声,如果某个通道噪声过高,就单独降低这个通道的噪声,不会影响其他通道清晰的人声;WNR风噪抑制技术则可以专门分析风噪声来自哪几个频率段,针对性进行抑制,出门散步、骑车的时候也能听得更清楚。和传统全频段压缩一刀切的方式不一样,这种逐通道/电极处理只会消除不需要的噪声,不会把人声一起压糊,哪怕是在极端嘈杂的操场、满座的餐厅这种复杂场景,最终传递给用户的人声依然是清晰干净的,不会出现噪声压下去了,人声也听不清的情况。
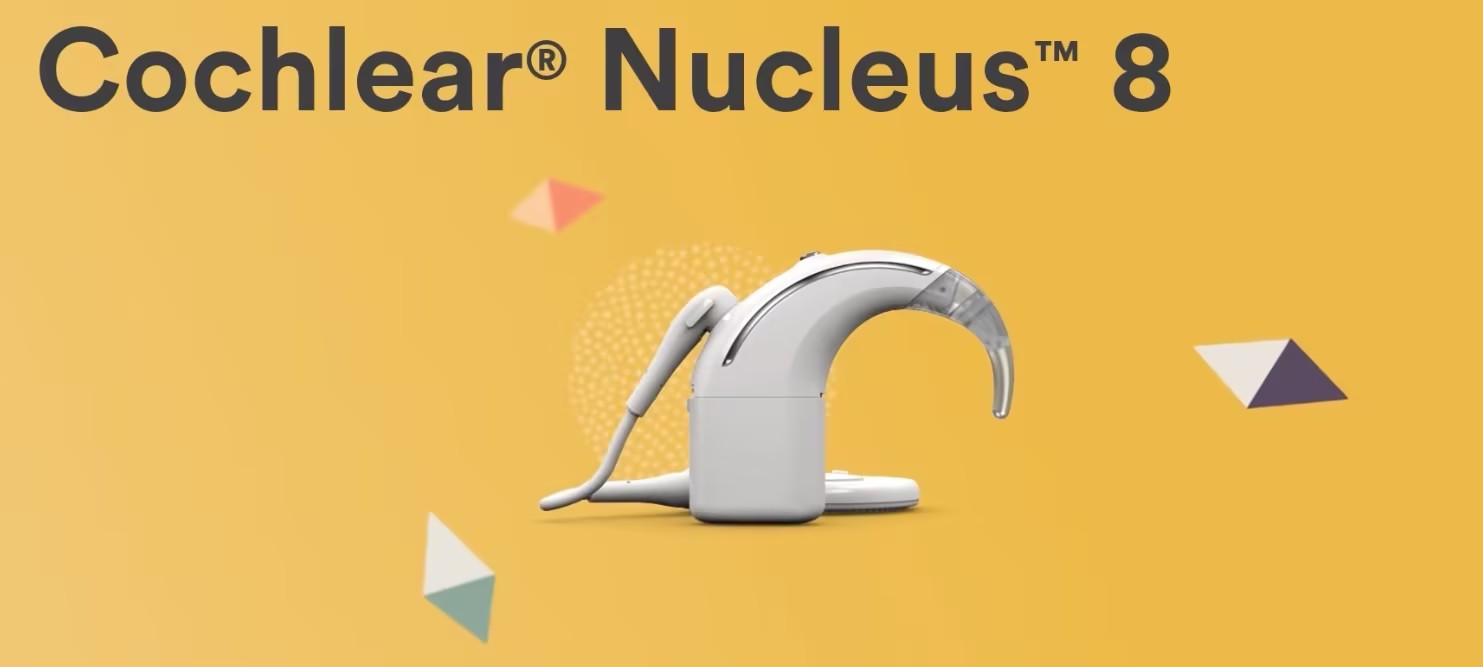
目前,科利耳不论是最新的 Nexa智能人工耳蜗 系统-Nexa植入体+Nucleus 8/Kanso 3的产品组合,还是CI622+Nucleus 7/Kanso 2的产品组合,都能为用户提供良好的降噪聆听体验。
判断人工耳蜗降噪效果好不好,核心要看降噪链路是否完整,从收声源头过滤,到聚焦目标人声,再到后端逐通道精修,三个环节缺一不可。传统全频段压缩的降噪逻辑,天生就容易出现“噪声小了人声也糊”的问题,而三级链路的降噪逻辑更适配我们日常的复杂嘈杂场景,更符合真实使用需求。需要提醒的是,人工耳蜗最终选型需要在正规医院耳鼻喉科做全面评估后,和专业医生共同做出决策,要结合个人的实际情况选择适配的方案,不要只看参数忽略自身适配性。
温馨提示:人工耳蜗最终选型需结合个人听损情况、耳蜗解剖结构,由专业医生综合评估确定,建议前往正规医疗机构检查评估,在医务人员指导下购买和使用,仔细阅读产品说明书。
(正文已结束)
推荐阅读:
免责声明及提醒:此文内容为本网所转载企业宣传资讯,该相关信息仅为宣传及传递更多信息之目的,不代表本网站观点,文章真实性请浏览者慎重核实!任何投资加盟均有风险,提醒广大民众投资需谨慎!